Как эффективно работать с инструкциями для AI-агентов, разбор материалов Anthropic, OpenAI и наших практик
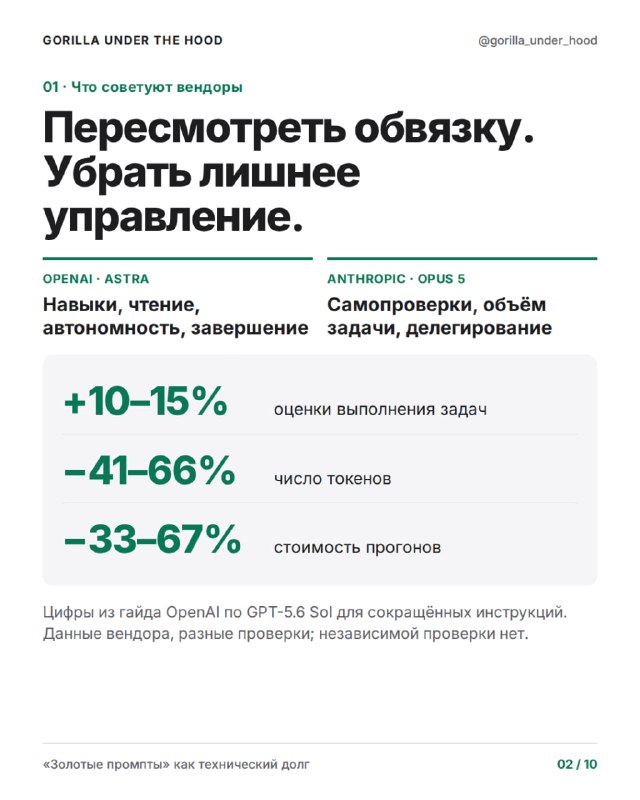
Вышли GPT-6 Astra и Claude Opus 5, и OpenAI с Anthropic выпустили к ним гайды - что менять в инструкциях и подходах для более эффективной работы
Некоторые вещи для нас были скажем так, не ожиданны, некоторые очевидны
Общая картина такова: «золотые промпты» - не работали и не сработают, приемы времен Opus 4.6-4.8 могут повредить эффективности моделей
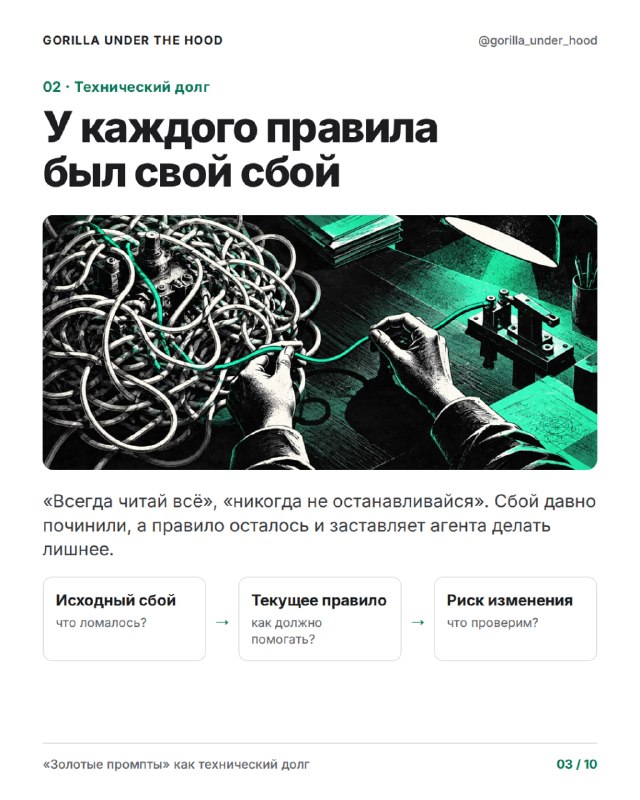
Правило «всегда читай всё» когда-то чинило конкретный сбой
Сбой исправили, а правило осталось
Теперь агент читает лишнее, повторяет проверки и останавливается не там
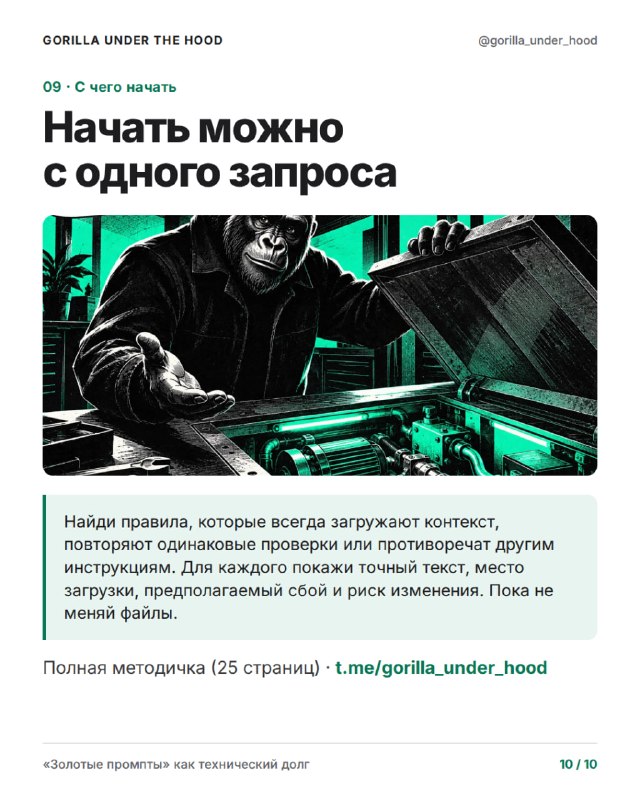
Собрали методичку, 25 страниц выжимки и иллюстраций(сори короче не получилось)
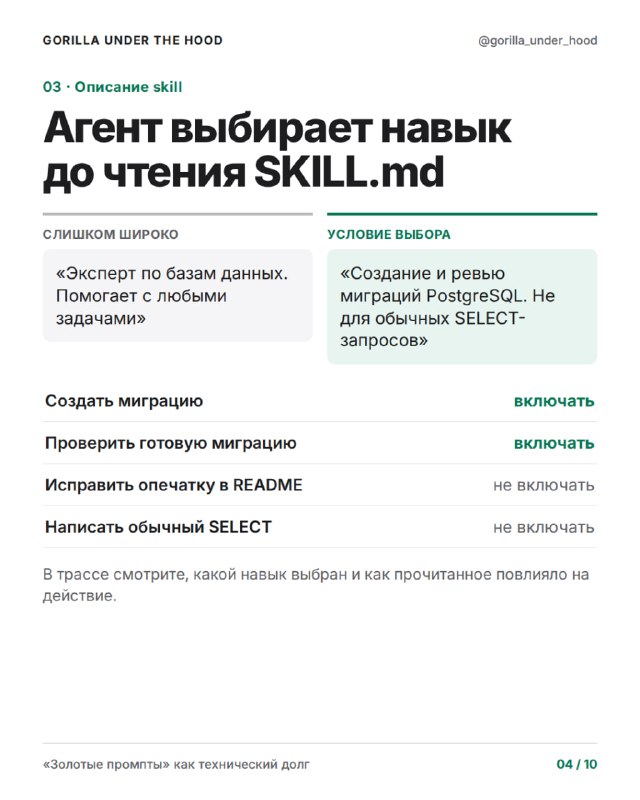
как описать skill, чтобы агент выбирал необходимое
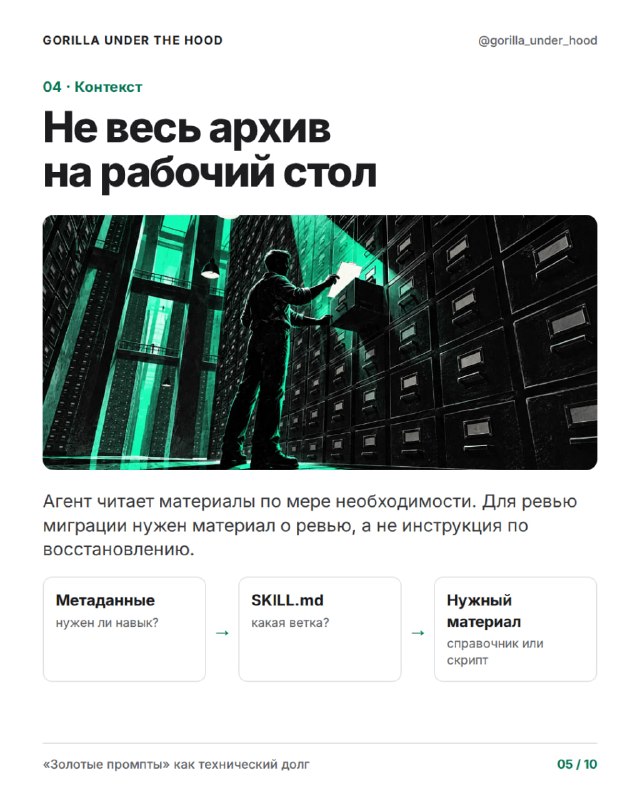
что грузить в контекст сразу, а что по запросу
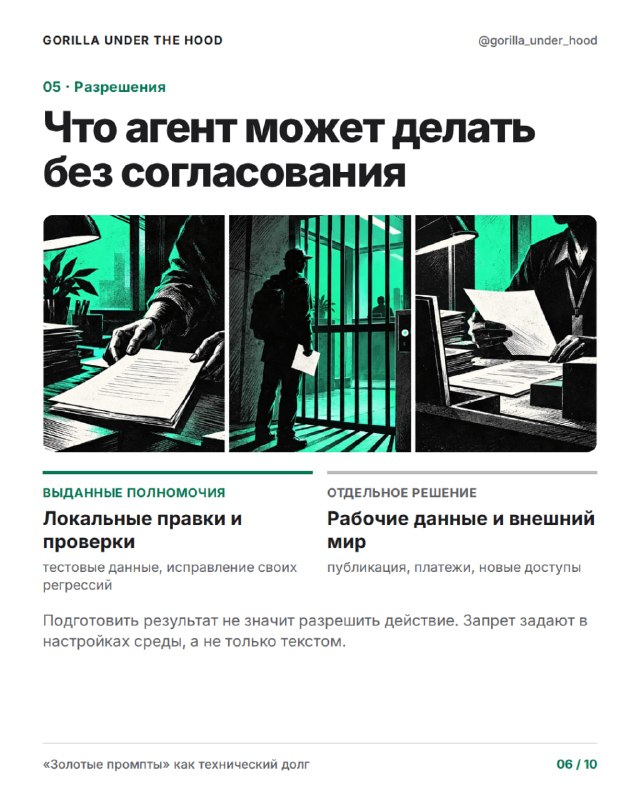
где граница между «подготовил» и «сделал»
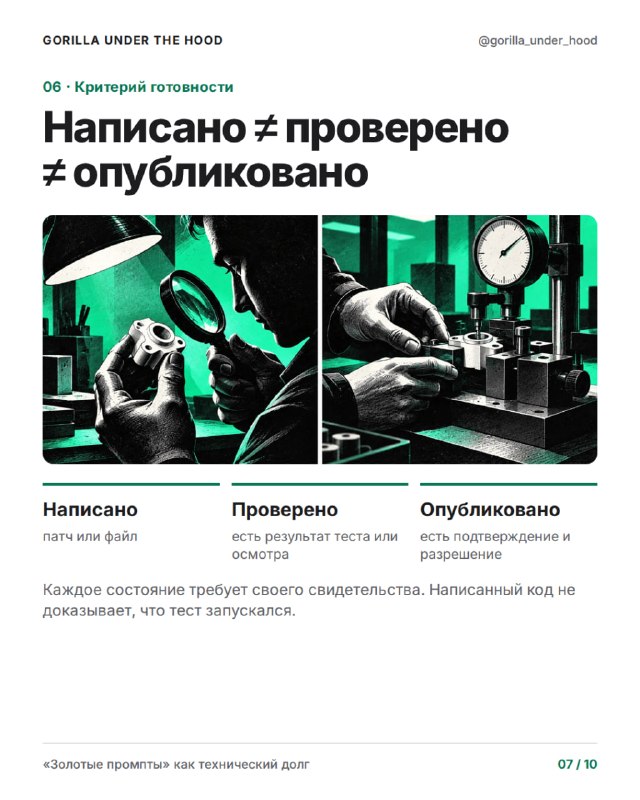
почему «написано», «проверено» и «опубликовано» это три разных состояния
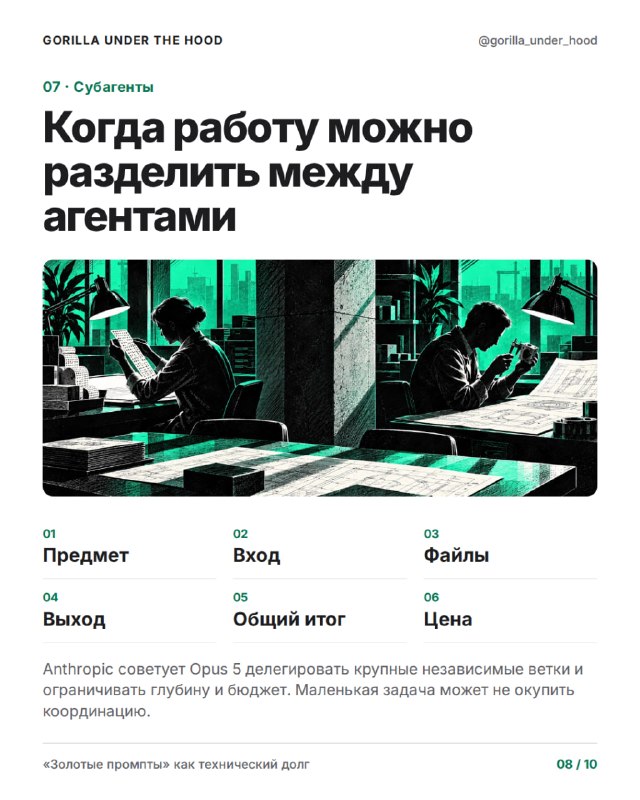
когда субагенты окупаются
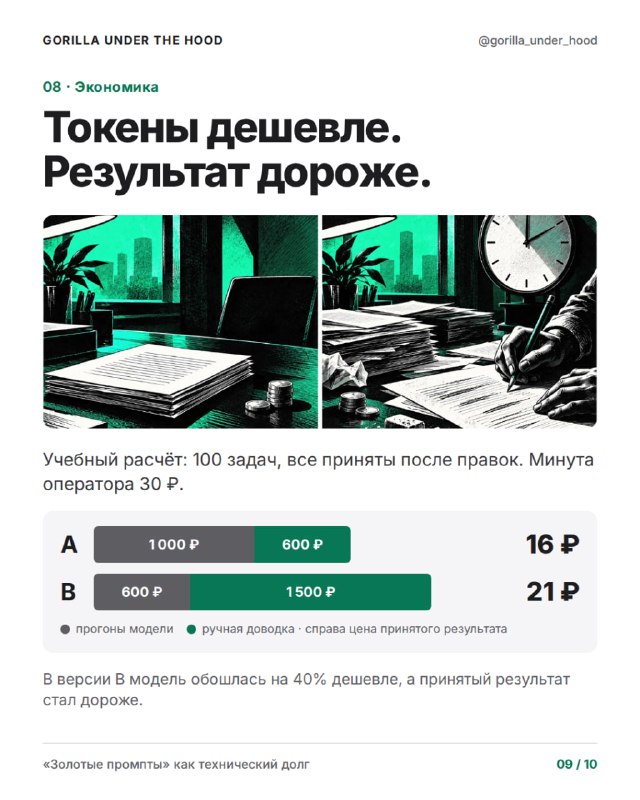
почему дешёвые токены могут дать дорогой результат
В карусели превью, полный разбор в PDF прикреплен к посту
Исходный пост 887 в Telegram ↗ Вышли GPT-6 Astra и Claude Opus 5, и OpenAI с Anthropic выпустили к ним гайды - что менять в инструкциях и подходах для более эффективной работы
Некоторые вещи для нас были скажем так, не ожиданны, некоторые очевидны
Общая картина такова: «золотые промпты» - не работали и не сработают, приемы времен Opus 4.6-4.8 могут повредить эффективности моделей
Правило «всегда читай всё» когда-то чинило конкретный сбой
Сбой исправили, а правило осталось
Теперь агент читает лишнее, повторяет проверки и останавливается не там
Собрали методичку, 25 страниц выжимки и иллюстраций(сори короче не получилось)
как описать skill, чтобы агент выбирал необходимое
что грузить в контекст сразу, а что по запросу
где граница между «подготовил» и «сделал»
почему «написано», «проверено» и «опубликовано» это три разных состояния
когда субагенты окупаются
почему дешёвые токены могут дать дорогой результат
В карусели превью, полный разбор в PDF прикреплен к посту