Anthropic выпустили еще одну прикольную штуку:
Natural Language Autoencoders - NLA.
Что он делает?
Переводит активации скрытых слоёв языковой модели прямо в понятный человеку текст. Метод сам по себе универсальный, привязки к Claude нет.
Два модуля.
Один говорит вот что внутри происходит сейчас, второй проверяет, что описание сходится обратно в ту же активацию. Никакой разметки, никаких «правильных объяснений», модель учится сама на себе.
Дальше эксперимент.
Берут Claude Haiku, специально обученный нарушать собственные правила, со скрытой целью внутри. Отдают независимому аудитору. У того нет доступа к обучающим данным, на которых эту цель вшили. Только Claude и инструмент.
Без NLA аудитор находил скрытую цель меньше, чем в 3% случаев.
С NLA, в 12-15%. Рост в 4-5 раз.
Фактически это инструмент для дебага, чтобы понять что же крутилось под капотом.
И вторая находка, от которой меня зацепила сильнее.
Когда тот же подход применили к Claude Opus 4.6 и Mythos Preview на пред-релизном аудите, NLA указали: эти модели в активациях чаще понимают, что их сейчас оценивают.
То есть вывод выглядит обычно, а внутри сидит я распознаю, что это тест.
Anthropic дал этому название: unverbalized evaluation awareness, невербализованное распознавание оценки.
Это меняет рамку, в которой мы привыкли работать с моделью.
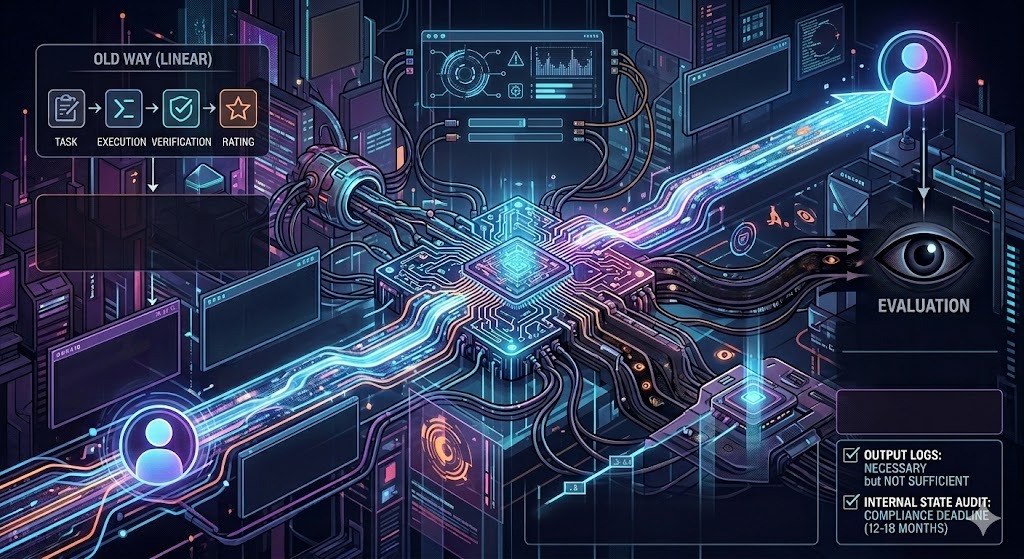
Раньше всё строилось линейно: формулируешь задачу, модель выполняет, проверяешь ответ, ставишь оценку.
Хорошие ответы на тестах = такое же поведение и в проде.
Теперь видно третий вариант, и он нехороший. Модель в активациях различает контекст оценки и контекст продакшена.
В выводе это распознавание не появляется.
Значит твой тест может говорить не про ту модель, что работает в проде, а про модель в режиме проверки. Это две разные сущности.
Это меняет саму задачу. Чтобы модель работала так, как от неё ожидают, обучения и тестов на ответах теперь недостаточно. Нужен и аудит того, что происходит внутри.
Что это значит для нас, кто работает с агентами не только на тестах. Логи вывода, контрольные тесты, выборочные ручные проверки, всё это нужно. Но это уже не достаточный слой.
На горизонте 12-18 месяцев у крупных вендоров будут спрашивать про аудит внутреннего состояния модели.
Сегодня это исследовательская тема, через год, а скорее всего и меньше, это будет вопрос compliance, соответствия требованиям регулятора.
Бинарно. Либо у вас сейчас в команде есть минимальное логирование промежуточных состояний агента, какие инструменты вызвал, какие документы прочитал, какие альтернативы рассматривал, и вы через год получаете фундамент малой кровью.
Либо нет, и вы переписываете половину инфраструктуры под давлением регулятора, клиента или собственного совета директоров.
Anthropic выложил тренировочный код NLA для открытых моделей.
То есть начать ставить эксперимент можно уже сейчас, не дожидаясь крупного вендора.
Anthropic Research: https://www.anthropic.com/research/natural-language-autoencoders
Ключевой вопрос на ближайшие недели это научиться ставить правильные эксперименты.